Tippek
Lokális AI-láz: hárommilliós gépet veszel, hogy havi hatvanezret spórolj?
szept
A közelmúltban több olyan „vevőm” is volt, aki nem vette meg a 24 GB-os MacBook Pro 14/16″t. Nem azért, mert lassú volt (basszus, gyakorlatilag a leggyorsabb gépek a világon – hogy ne kössenek belém, 150W fogyasztás alatt 😃 ).
És nem azért, mert drága, hanem azért, mert „lokális AI-hoz kevés a 24 giga, ahhoz minimum 48 kell”. Aztán megkérdezte, mennyiért tudnék szerezni egy Mac Studiót M5 Ultrával, 96 vagy inkább 256 GB memóriával. Mert studiora tudna akár 2mFt-ot is adni. (Ha nem vagy benne, erről a gépről beszélünk, szerény 3-5mFt-os árral)

Ez az a pont, ahol le kell ülni számolni. Mert ha a cél az, hogy ne kelljen havonta fizetni egy AI-előfizetést, akkor a Mac Studio erre elég drága válasz.
Mennyibe kerül ma az, amit meg akarsz spórolni?
Két fogalmat kell tisztázni.
A bemeneti token az, amit te küldesz a modellnek: a kérdés, a beillesztett kód, a csatolt dokumentum, és minden korábbi üzenet a beszélgetésből. Igen, az egészet, minden egyes körben, hacsak a gyorsítótár nem menti meg a helyzetet. Ez később még fontos lesz. A kimeneti token az, amit a modell visszaír. Egy token nagyjából négy karakter angolul. Magyarul rosszabb az arány: a ragozott, ékezetes szövegünk több darabra esik szét ugyanannyi mondanivalóért.
Az Anthropic mai listaára millió tokenenként:
| Modell | Bemenet | Kimenet |
|---|---|---|
| Haiku 4.5 | 1 $ | 5 $ |
| Sonnet 5 | 2 $ | 10 $ |
| Opus 5 | 5 $ | 25 $ |
| Fable 5.1 / Mythos 5.1 | 10 $ | 50 $ |
Ehhez jön, hogy a gyorsítótárból visszaolvasott bemenet a tizedébe kerül, a kötegelt feldolgozás pedig fele annyiba. Mindegyik modell egymillió tokenes kontextussal megy, felár nélkül.
Hogy legyen viszonyítási alap: egymillió token nagyjából 750 ezer angol szó. Több ezer oldalnyi szöveg, néhány dollárért.
Az előfizetések: Pro 20 €, Max 5x 100, Max 20x 200 EUR havonta. A mai árfolyamon a legdrágább csomag nagyjából 60 ezer forint körül van. Cégre EU adószámra áfát ugye nem kell fizetni, ott is meg lehet fogni a jó kis 27%-unkat. Ennyi az az összeg, amit meg akar havonta spórolni.
És hogy ez sok-e? Egy napi szinten kódoló fejlesztő fogyasztása havi 80–200 dollár körül jön ki API-áron, egy folyamatosan ügynököt futtató nehéz felhasználóé 250–700 dollár felett. A 200 dolláros csomag tehát pont azoknál olcsóbb, akik a legtöbbet használják. Lényegében mennyiségi kedvezmény.
Hány GB RAM kell a lokális AI-hoz? Itt a képlet
Szakzsargony: 4 bites kvantálással 0,5–0,6 gigabájt memória kell milliárd paraméterenként. A gyakorlatban a felső érték a reális, mert a kontextushoz tartozó gyorsítótár is elfér valahol. Ebből a többi már fejben jön.
| Memória | Mekkora modell fér el (4 bit) | Konkrét példa |
|---|---|---|
| 16 GB | 12–14 milliárd | Gemma 4 12B |
| 24 GB | 30–35 milliárd (MoE) | Qwen3.6-35B-A3B, kb. 21 GB |
| 48 GB | 80 milliárd MoE | Qwen3-Coder-Next 80B, kb. 46 GB |
| 96–128 GB | 140–200 milliárd | GPT-OSS 120B kényelmesen |
| 256 GB | 400 milliárd körül | Llama 4 Maverick (400B) |
| 512 GB | 750–850 milliárd | GLM-5.2 (753B), kontextussal együtt épphogy |
| Engedd el | 1,6–2,8 billió | DeepSeek V4 Pro, Kimi K3 (kb. 1,6 TB súly) |

A mai legjobb nyílt súlyú modellek, a Kimi K3 a maga 2,8 billió paraméterével és a DeepSeek V4 Pro 1,6 billióval, még az októbertől kapható, 8,9 millió forintos, 512 GB-os Mac Studión sem futnak el. Azokhoz több H200-as vagy B200-as kártyából álló szerver kell, nem asztali gép.
Szóval amikor valaki azt mondja, hogy „megveszem a nagy gépet, és futtatom a legjobb nyílt modellt”, az egyszerűen nem igaz. A nagy gépen is a középmezőnyt futtatod, csak sokkal drágábban.
Mit tud az a középmezőny? A Qwen3-Coder-Next 80B, amiért az a bizonyos 48 GB kell, 70,6%-ot ér el az SWE-bench Verified teszten. A GLM-5.2, amihez már 512 GB kellene, 78,7%-ot. A zárt csúcsmodellek ugyanezen a méréshalmazon 95% körül és felett járnak. A nehezebb gondolkodási feladatokban a szakadék még ennél is nagyobb. – Értsd: veszel egy közel 10milliós gépet és a legjobb elérhető modell is még jóval butább az előfizetéseseknél.

És ez még mindig angol nyelvű mérés. Magyarul a kisebb nyílt modellek érezhetően butábbak, mint angolul, míg a nagy szolgáltatói modellek jóval kevesebbet esnek vissza. Ezt nem a benchmarkban látod, hanem minden második válasznál.
A sebesség, amiről a „token per másodperc” videók hallgatnak
A helyi futtatásnak két külön fázisa van, és a YouTube-on szinte mindenki csak a másodikat méri.
Az első a prompt feldolgozása. Mielőtt egyetlen betű megjelenne a képernyőn, a gépnek végig kell rágnia az egész bemenetet: a rendszerpromptot, az eszközleírásokat, a beolvasott fájlokat, az egész eddigi beszélgetést. Ez nyers számítási teljesítményt eszik, és a kontextus hosszával egyre rosszabb. A második fázis a generálás, az már memória-sávszélesség kérdése, és az kerül a videók címébe.
Egy konkrét mérés a régebbi, M3 Ultrás Mac Studióról: egy 15 777 tokenes prompt feldolgozása 227 másodpercig tartott, a generálás pedig 5,79 token/másodpercre esett vissza. Majdnem négy perc várakozás az első szóig, egy olyan kontextussal, ami egy komolyabb kódbázisnál semmiség.
Az M5 Ultra ezen sokat javít, az Apple szerint négyszeres a prompt-feldolgozás a régihez képest. Egy független mérés szerint viszont egy 96 GB-os RTX Pro 6000 még így is 3,46-szor gyorsabban végez ugyanazzal.
A helyi ügynök-munkát ez öli meg, nem a token/mp. A jó futtatókörnyezetek persze gyorsítótárazzák a prompt elejét, csakhogy egy ügynök munkája közben folyton változik az, ami korábban volt: új fájl kerül be, egy eszköz visszaír valamit, és a gyorsítótár elszáll. Húsz kör után a huszadik kérdésed sokszorosába kerül időben, mint az első.
Megéri Mac Studiót venni lokális AI-hoz? Nézzük a megtérülést
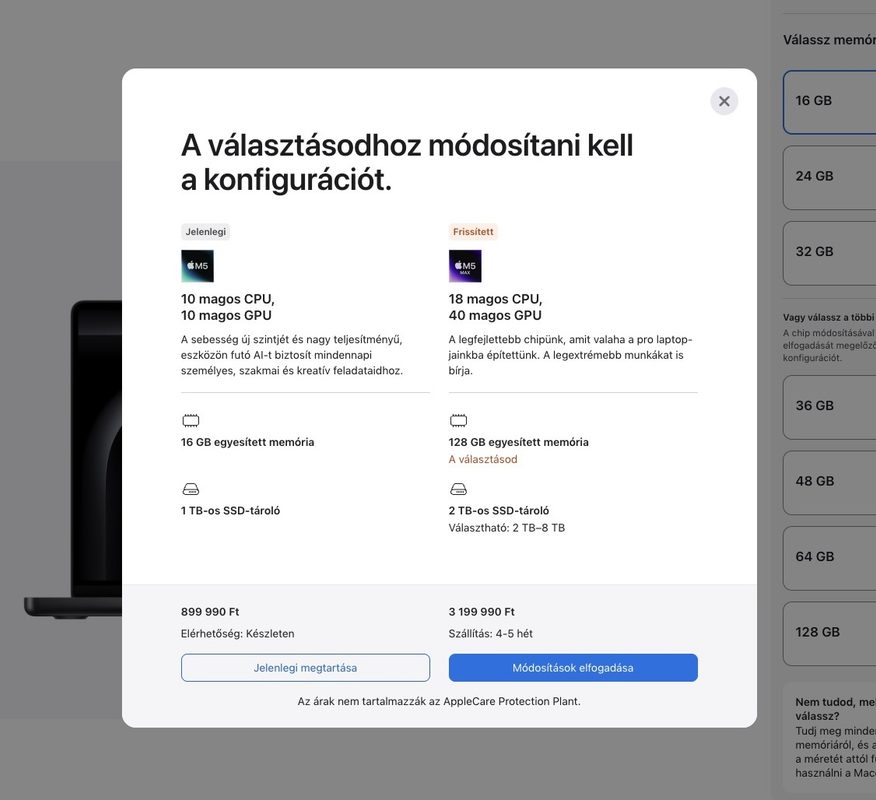
Számoljunk konkrét árakkal. A MacBook Pro 14 M5, 24 GB memóriával és 1 TB SSD-vel listaáron 999 990 Ft. A Mac Studio M5 Max 36 GB-tal 1 099 990 Ft, az M5 Ultra 96 GB-tal 2 499 990 Ft, és onnantól a memóriabővítés viszi 3 millió fölé.
Vegyük a legkedvezőbb esetet, amiben a Studio kiváltja a laptopot. A különbözet 1,5 millió forint, elosztva a megspórolt 63 ezerrel: huszonnégy hónap.
Csakhogy egy Mac Studiót nem viszel magaddal ügyfélhez, tehát a laptop marad. Így a Studio teljes ára pluszköltség: negyven hónap. Több mint három év, áram nélkül, a gép értékvesztése nélkül, és úgy, hogy közben végig a mai modellt futtatod a mai sebességen.
Aztán ott a csattanó, amit használtgép-kereskedőként rendszeresen vélelmezek: a legtöbb ilyen gépen soha nem indul el komolyan a lokális modell. Van két hét lelkesedés, pár LM Studio-s próbálkozás, aztán a tulaj visszamegy a felhőbe, mert az egyszerűen jobb. A plussz memóriát pedig onnantól ugyanúgy Chrome-fülekre és Lightroomra használja, mint bárki más. (Arra meg tök sok 128GB, jó, esetleg a chrome végre ki tud nyújtózni :D) De hogy így erre elköltöttél +2mFt-ot 🥶
2026 a lehető legrosszabb év memóriát venni
Ezt a részt üzleti szemmel is érdemes nézni. A DRAM-piac idén történelmi drágulást produkál: a második negyedévben nagyjából 60%-os ugrás volt, a harmadikban további 13–18% jön, és a szűkösség a gyártók szerint évekig velünk marad. (Szerintem full hiszti és kartell, de az alusisakos összeesküvéselméletemet majd máskor szabadítom az emberiségre )
Az Apple idén márciusban csendben kivezette az előző Mac Studio 512 GB-os konfigurációját, májusban pedig a 128 GB-osat is, így a maximum egy időre 96 GB lett. A szállítási idők közben hat napról hat, majd kilenc-tíz hétre nyúltak. A most rendelhető gépeknél a magyar kereskedő is legalább két hónapot ír egyedi konfigurációra.
Aki tehát ma vesz 128 GB egyesített memóriát „a lokális AI miatt”, az a memóriaárak csúcsán vásárol, egy olyan piacon, ahol pont a mesterséges intelligencia hajtotta fel az árakat. Két éve ugyanennyi memória a töredékébe került.
(Zárójeles megjegyzés: én ezeket a gépeket HA meg tudom szerezni, sokszor a sokkal olcsóbban adom, de jelenleg még az alapkonfigok is masszívan hiánytermékek.)
Miért jobb bérelni, mint venni
Az előfizetés valójában bérlés. Tudom, hogy Magyarországon a bérlés szitokszó, és hogy ez a hasonlat itt sántít, de bírd ki egy bekezdésig, mert a lényeg átjön.
Havonta fizetsz, cserébe bármikor felmondhatod. Ha holnap jön valaki jobbal vagy olcsóbbal, egy fájl átírásával átköltözöl. Nem kell eladnod semmit, nincs lekötve a pénzed.
Ez a rugalmasság forintban is mérhető. Az Anthropic júniusban 2 és 10 dolláros bevezető áron hozta a Sonnet 5-öt, szeptember 1-től jött volna az emelés, aztán augusztus 11-én bejelentették, hogy a kedvezményes ár marad véglegesen. Közben viszont az új tokenizáló ugyanarra a szövegre nagyjából 30%-kal több tokent számol, tehát a listaár állva maradt, a valós költséged mégis mozdult. Fel is, le is, folyamatosan. Amíg bérelsz, minden ilyen mozgásnál dönthetsz. Aki kifizette a gépet, annál az „árváltozás” annyit jelent, hogy a vasa minden hónappal kevesebbet ér.
És ha tényleg megjelenik holnap az a bizonyos zseniális, kicsi, ingyenes modell? Akkor sem kell gépet venni hozzá. Egy RTX 5090 óradíja ma medián 0,65 dollár, egy H200-é 4,29, egy B200-é 6,13. Napi két óra 5090-en havi negyven dollár. Csúcshardvert bérelni még soha nem volt ilyen olcsó, pont azért, mert most mindenki épít. Videókártyát se a bányászláz TETEJÉN volt jó buli venni, ott bérelni is lehetett értelmesen, aztán meg pár évvel később eljöttem a használt, de jó kártyákért. Szoki helyzet: ha nagy az aranyláz, legjobban a lapátot éri meg eladni hozzá, nem beugrani a hype kellős közepébe.
Az meg, hogy ma fixálod a következő négy évedet a mai vason: nagyjából olyan, mintha egy lakóparkban vennél lakást úgy, hogy a szomszéd telken már ásnak a következőnek, és a rákövetkezőnek is. Nem az a baj, hogy rossz házat vettél. Az a baj, hogy akár pár hónap múlva ugyanennyiért jobbat kapnál.
Mikor van tényleg értelme a lokális AI-nak?
Van. Négy ilyen esetet látok.
Ha a céges vagy ügyféladat nem hagyhatja el a gépet, mert ügyvédi, egészségügyi, védelmi területen dolgozol, vagy NDA köt, akkor ez nem pénzkérdés. Ott muszáj helyben futtatni, és teljesen mindegy, hány hónap alatt térül meg.
Ugyanígy van értelme, ha egyetlen szűk feladatból futtatsz óriási mennyiséget: osztályozás, címkézés, kivonatolás. Ott egy kicsi modell is bőven elég, és a darabszám miatt tényleg kijön. Van értelme, ha offline is működnie kell, mondjuk terepen vagy zárt hálózaton. És van értelme, ha egyszerűen tanulni akarsz: megérteni, mit csinál a kvantálás, hol dől el a sebesség, mitől lesz jó egy prompt. Ehhez viszont elég a meglévő géped, nem kell hozzá hárommilliós beruházás.
Ami viszont nincs ezen a listán: „megspórolom a havidíjat”.
Mit vegyél tehát?
A 24 GB-os MacBook Pro 14 attól még kiváló gép, hogy nem fut rajta a Kimi K3-at. A 2,5 milliós Mac Studión sem fut. Ami viszont elfut rajta: egy 30 milliárd paraméteres MoE modell, kényelmesen, 21 GB alatt. Két éve ez még a csúcskategória volt.
Vedd meg azt a gépet, amin a munkádat csinálod. Ha a munkád 4K-s videóvágás vagy egy nagy Xcode-projekt, akkor kell a 48 vagy 64 giga, és nem kell hozzá AI-indok. Ha a munkád e-mail, böngésző, kód és néha egy Lightroom-katalógus, akkor a 16GB is elég. 24 GB pont jó. A maradék másfél millióért két éven át futtathatod a világ legjobb modelljét a legdrágább csomagon, vagy négy évig a százdollároson. Azt a modellt, amelyik közben évente kétszer-háromszor kicserélődik valami jobbra, felár nélkül.
Ha nem tudod eldönteni, melyik kategória a tiéd, a gépválasztónk végigvezet rajta. Spoiler: a TE pénztárcád nézem és van, hogy inkább egy olcsóbb MacBook Airt javaslok. Nekem már nem kell többet keresnem, ha cserébe veszítek a gerincemből, így őszintén tudok segíteni.
A lokális AI izgalmas, és pár év múlva valószínűleg tényleg ez lesz az alapértelmezett. Csak ne a spórolás legyen az indok, mert ma ez még kiadás, nem megtakarítás.
Gyakori kérdések
Elég a 24 GB RAM lokális AI-hoz?
Bőven elég ahhoz, hogy komolyan kipróbáld. Egy 30–35 milliárd paraméteres MoE modell 4 bites kvantálással 21 GB körül elfér, és értelmes sebességgel fut. Fun fact: memória sávszél nagyon sokat számít, így egy páréves MAX-os modell jobb buli, mint gyengébb CPU-s (sima, vagy Pro procis M5-M6)-os gép. Mondom ezt úgy, hogy nagyon ritkán tudok jó maxos gépet szerezni.
Mennyi RAM kell egy 70 milliárd paraméteres modellhez?
4 bites kvantálással nagyjából 40 GB a súlyoknak, plusz a kontextus, tehát a gyakorlatban 48 GB-tól indul. 64 GB-on már kényelmes.
Megéri 128 GB-os gépet venni AI miatt?
Ha csak azért, hogy megspórold a havidíjat, akkor nem: a megtérülés 24–40 hónap, mai árakon és mai modellekkel. Ha a napi munkád (videó, 3D, virtualizáció) amúgy is igényli, akkor a memória jó befektetés, csak nem AI-indokkal.
Mennyivel butább egy lokális modell a Claude-nál?
A legjobb otthon futtatható modellek 70–79% körül teljesítenek az SWE-bench Verifieden, a zárt csúcsmodellek 95% körül és felett. Magyar szövegnél a különbség még nagyobb.
Mennyibe kerül havonta egy AI-előfizetés?
20 dollártól 200 dollárig, ami körülbelül 6 és 63 ezer forint között van. A legtöbb komoly felhasználónál ez olcsóbb, mint ugyanez tokenre fizetve API-n.
Források: Claude Platform árazás · CloudZero – Claude pricing 2026 · Morph – AI coding costs · Morph – nyílt kódú modellek · Wavect – nyílt súlyú modellek · Implicator.ai – M5 Ultra prompt-feldolgozás · Tom’s Hardware – memóriaárak · Sonnet 5 árbefagyasztás · GetDeploying – GPU-bérlési árak · Tech2 – Mac Studio magyar árak · iSTYLE – MacBook Pro 14 M5. Nyitókép: Iewek Gnos / Unsplash.

